Súbor robots txt patrí medzi najmenšie, no zároveň najcitlivejšie súbory na celom webe. Jeden nesprávny riadok dokáže vyhľadávačom zablokovať prístup k celej stránke a poslať jej pozície v Google strmhlav dole. V tomto článku si vysvetlíme, ako robots.txt funguje, akú má syntax a ako sa vyhnúť chybám, ktoré pri technickom SEO vidíme najčastejšie.
Čo je súbor robots.txt a načo slúži
Robots.txt je jednoduchý textový súbor, ktorý sa nachádza v koreňovom adresári webu, napríklad na adrese www.vasadomena.sk/robots.txt, a hovorí vyhľadávacím robotom, ktoré časti webu môžu alebo nemôžu prechádzať. Nejde o bezpečnostný mechanizmus ani o spôsob, ako stránku skryť pred verejnosťou, ale o odporúčanie pre proces crawlingu, teda systematické prechádzanie webu, akým Googlebot a ďalší roboti objavujú jeho obsah.
Súbor vychádza z takzvaného Robots Exclusion Protocol, ktorý vznikol už v roku 1994 a odvtedy sa stal neoficiálnym, no všeobecne rešpektovaným štandardom. Rešpektujú ho veľkí vyhľadávači ako Google, Bing alebo Seznam, no drobní či škodliví roboti sa pravidlami z robots.txt riadiť nemusia. Práve preto sa doň nikdy nemajú vkladať citlivé alebo súkromné časti webu, iba pokyny pre serióznych crawlerov.
Ako funguje syntax súboru robots txt
Syntax robots.txt je založená na jednoduchých direktívach, ktoré sa zapisujú do párov v tvare direktíva: hodnota. Každá skupina pravidiel začína riadkom User-agent, ktorý určuje, pre ktorého robota platia nasledujúce pokyny.
| Direktíva | Význam | Príklad |
|---|---|---|
| User-agent | Určuje, ktorého robota sa pravidlo týka | User-agent: Googlebot |
| Disallow | Zakazuje prístup k danej ceste | Disallow: /admin/ |
| Allow | Povoľuje prístup, aj keď je nadradený priečinok blokovaný | Allow: /blog/ |
| Sitemap | Odkazuje na súbor mapy stránok | Sitemap: https://www.vasadomena.sk/sitemap.xml |
| Crawl-delay | Nastavuje oneskorenie medzi požiadavkami (Google ho ignoruje) | Crawl-delay: 10 |
Riadok Sitemap sa v praxi oplatí do robots.txt vždy pridať, pretože robotom priamo ukazuje cestu k sitemape, teda k prehľadu všetkých stránok, ktoré chcete mať v Google indexované. Nie je to povinné, keďže mapu stránok viete nahrať aj priamo v Google Search Console, no zjednodušuje to objavovanie nového obsahu najmä pri weboch, ktoré sa neaktualizujú úplne pravidelne.
Ako vyzerá robots txt example v praxi
Najlepšie sa syntax pochopí na konkrétnom príklade. Bežný robots.txt e-shopu alebo firemného webu môže vyzerať takto:
User-agent: *
Disallow: /kosik/
Disallow: /moj-ucet/
Disallow: /wp-admin/
Allow: /wp-admin/admin-ajax.php

Sitemap: https://www.vasadomena.sk/sitemap.xml
Hviezdička pri User-agent znamená, že pravidlá platia pre všetkých robotov. Riadky Disallow vylučujú z prechádzania košík, prihlásenie zákazníka aj administráciu, keďže riadok Allow robí výnimku pre súbor, ktorý web potrebuje na fungovanie na pozadí. Takto nastavený súbor navyše šetrí takzvaný crawl budget, teda obmedzený počet stránok, ktoré si Googlebot pri jednej návšteve webu prejde.
Robots txt disallow vs noindex meta tag: V čom je rozdiel
Jedna z najčastejších chýb je zamieňanie Disallow v robots.txt s meta tagom noindex. Disallow len hovorí robotovi, aby danú stránku neprechádzal, no ak na ňu vedie odkaz z iného webu, Google ju napriek tomu môže zaradiť do výsledkov vyhľadávania, často len ako holú URL adresu bez popisu.
Naopak meta tag robots txt no index, teda meta name robots content noindex, robotovi povoľuje stránku prechádzať, ale výslovne mu zakazuje zaradiť ju do indexovania. Ak teda chcete, aby sa stránka skutočne nezobrazovala vo výsledkoch vyhľadávania, riešením je práve noindex, nie Disallow.
| Situácia | Riešenie |
|---|---|
| Stránka sa nemá prechádzať ani indexovať a nevedie na ňu žiadny externý odkaz | Disallow v robots.txt |
| Stránka sa nemá zobrazovať vo vyhľadávaní, ale robot ju smie prechádzať | Meta tag noindex |
| Stránka sa má prechádzať aj indexovať bežným spôsobom | Bez obmedzenia |
Kombinácia oboch pravidiel súčasne je pomerne bežná chyba. Ak stránku zablokujete cez Disallow, Google sa k nej vôbec nedostane, a teda ani neuvidí tag noindex, ktorý ste na ňu prípadne pridali. Výsledkom môže byť, že stránka zostane v indexe dlhšie, než ste čakali.
Najčastejšie chyby pri nastavovaní robots.txt
Robots.txt je síce jednoduchý súbor, no práve jeho jednoduchosť zvádza k neopatrnosti. Medzi najčastejšie chyby, s ktorými sa v technickom SEO stretávame, patria:
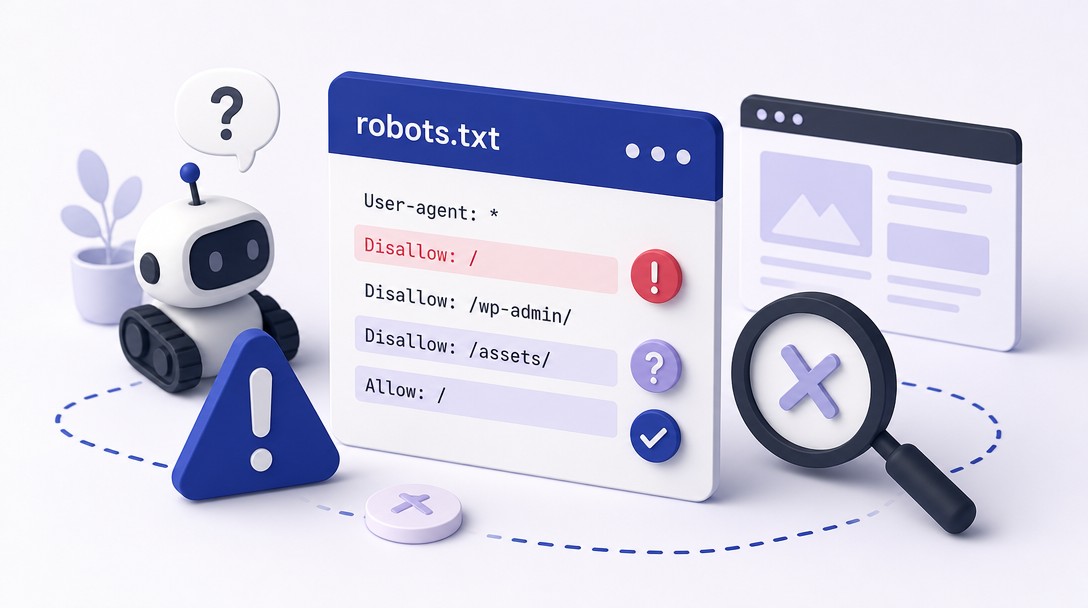
- Zablokovanie celého webu omylom, stačí jeden riadok Disallow: / bez ďalšej špecifikácie a vyhľadávače prestanú prechádzať úplne celý web.
- Blokovanie súborov CSS a JavaScript, ak roboti nevidia, ako sa stránka vizuálne vykresluje, Google ju môže vyhodnotiť ako horšie použiteľnú, čo sa premieta aj do hodnotenia rýchlosti a stability zobrazenia, teda ukazovateľov Core Web Vitals.
- Zabudnutý Disallow po spustení nového webu, počas vývoja sa bežne celý staging zablokuje cez Disallow: /, aby ho vyhľadávače neindexovali predčasne. Problém nastáva, keď sa rovnaký súbor omylom prenesie aj na ostrú verziu a web tak zostane pre Google neviditeľný celé týždne, kým si to niekto všimne.
- Nesprávne umiestnenie súboru, robots.txt musí byť vždy priamo v koreňovom priečinku domény, nie v podpriečinku, inak ho vyhľadávače nenájdú.
- Snaha skryť citlivé údaje cez robots.txt, keďže je súbor verejne dostupný, uvedenie ciest k neverejným sekciám v ňom môže naopak upozorniť na ich existenciu.
Práve preto, že dôsledky jednej zle napísanej direktívy môžu byť pre viditeľnosť webu drastické, sa oplatí nastavenie robots.txt overiť v rámci širšieho technického SEO, ktoré preverí aj ďalšie faktory ovplyvňujúce crawlovanie a indexovanie webu.
Ako otestovať robots txt cez Google Search Console
Checking robots txt by nemala byť jednorazová záležitosť, ale súčasť pravidelnej kontroly webu, najmä po každej väčšej zmene štruktúry alebo redizajne. Google Search Console na to ponúka priamy nástroj.
- Prihláste sa do Google Search Console a vyberte overenú property svojho webu.
- V ľavom menu nájdite sekciu Nastavenia a v nej odkaz na robots.txt report, ktorý zobrazuje poslednú načítanú verziu súboru priamo z vašho webu.
- Skontrolujte dátum poslednej kontroly a prípadné chyby alebo upozornenia, ktoré Google pri čítaní súboru zaznamenal.
- Ak obsah robots.txt zmeníte, požiadajte v reporte o opätovné načítanie, aby Google pracoval s aktuálnou verziou.
- Doplnkovo si adresu jednotlivých URL môžete overiť aj cez nástroj na kontrolu URL, ktorý ukáže, či Google konkrétnu stránku môže prechádzať a indexovať.
Kompletný postup nastavenia a práce s nástrojom rozoberáme podrobne v článku o Google Search Console, kde nájdete aj ďalšie reporty, ktoré stoja za pravidelnú kontrolu.
Robots.txt a llms.txt: Podobný princíp pre AI vyhľadávanie
S nástupom AI vyhľadávania a chatbotov, ktoré čerpajú z obsahu webových stránok, sa popri robots.txt začal presadzovať aj podobný, zatiaľ neoficiálny štandard. Otázka, ako riadiť prístup rôznych typov robotov k webu, tak dnes presahuje klasické vyhľadávače.
Kým robots.txt komunikuje s klasickými vyhľadávacími robotmi, súbor llms.txt má jazykovým modelom poskytovať prehľadný súhrn obsahu webu. Oba súbory majú spoločné to, že sídlia v koreňovom priečinku domény a fungujú na princípe dobrovoľného odporúčania, nie vynútiteľného príkazu.
Kedy si nechať robots.txt skontrolovať v rámci SEO auditu
Ak neviete s istotou povedať, čo presne váš robots.txt momentálne blokuje, alebo ste ho od spustenia webu ani raz neupravovali, je to jasný signál na kontrolu. Rovnako platí, ak ste nedávno prešli redizajnom, zmenili štruktúru URL adries alebo migrovali web na novú platformu.
Podrobnú kontrolu robots.txt spolu s ďalšími technickými faktormi, ako sú presmerovania, štruktúrované dáta či rýchlosť načítania, prináša technický SEO audit, ktorý odhalí, či váš web crawlerom nekladie zbytočné prekážky.
Malý súbor s pár riadkami textu tak dokáže rozhodnúť o tom, či Google váš web vôbec uvidí v plnom rozsahu. Ak si nie ste istí, kde presne váš web stráca body vo vyhľadávačoch, komplexný SEO audit preverí robots.txt aj desiatky ďalších faktorov naraz a dá vám konkrétny zoznam krokov na zlepšenie viditeľnosti webu.